Neu: AI Workspace – Sichere KI für Organisationen mit sensiblen Daten. Jetzt mehr erfahren.




Direkte und indirekte Prompt Injection: Unterschiede zum Jailbreak
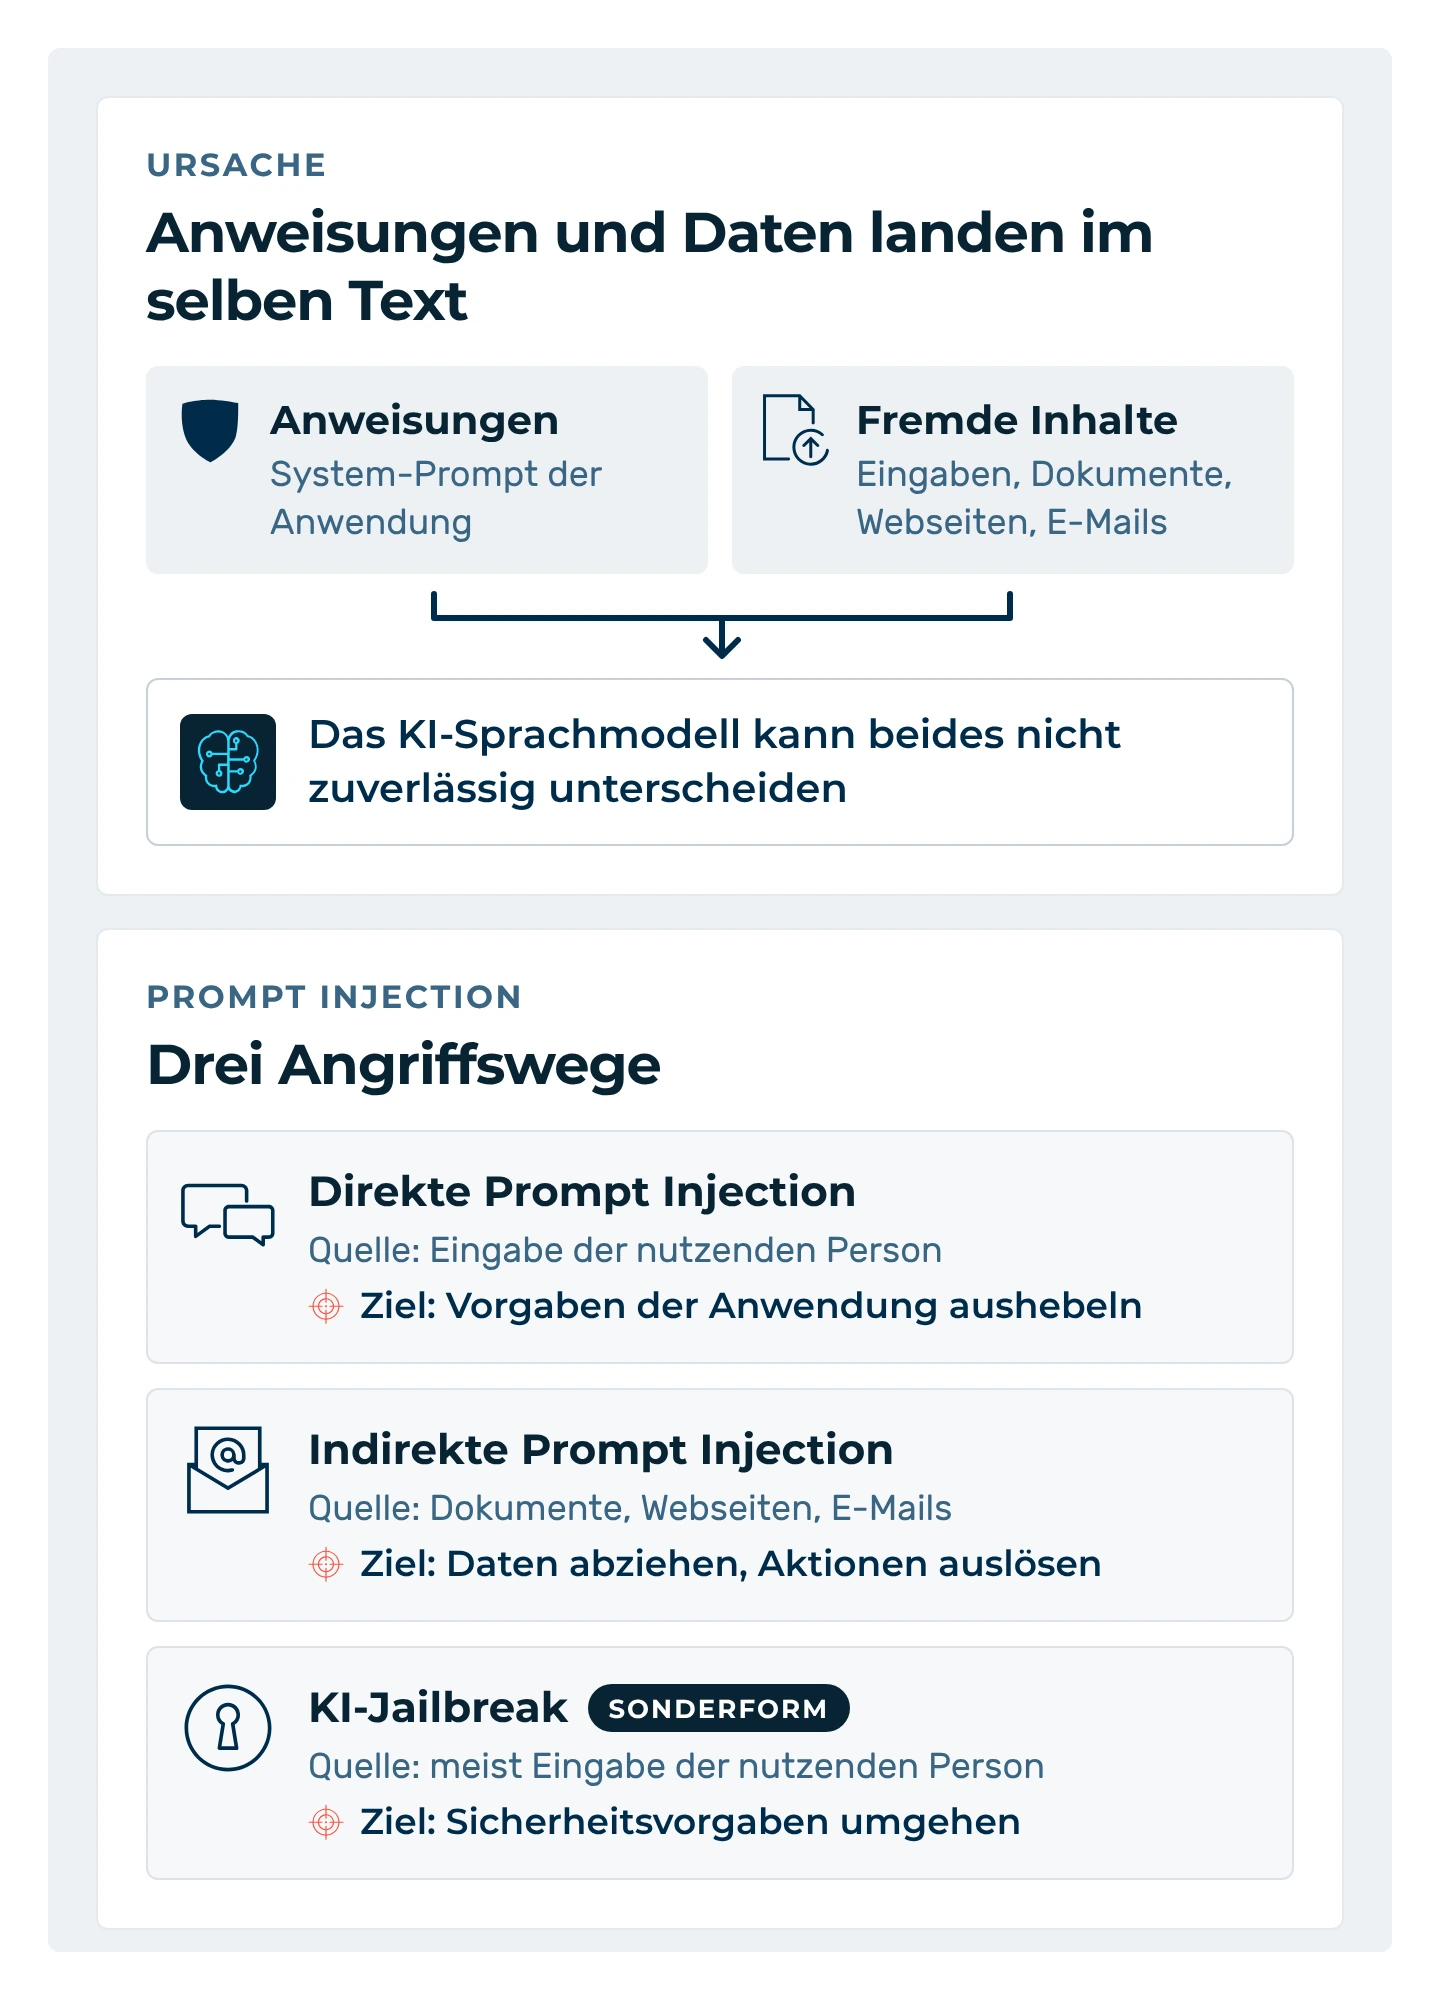
Entscheidend ist, woher die eingeschleuste Anweisung stammt und worauf der Angriff abzielt.
Direkte Prompt Injection
Im Eingabefeld der Anwendung
Die nutzende Person selbst
Anwendungsvorgaben aushebeln oder Systemanweisungen offenlegen
Indirekte Prompt Injection
In Dokumenten, Webseiten, E-Mails oder Werkzeugergebnissen, die das Modell verarbeitet
Dritte, häufig unbemerkt von den Betroffenen
Daten abziehen, Aktionen auslösen oder Antworten verfälschen
KI-Jailbreak beziehungsweise LLM-Jailbreak
Meist in einer Eingabe, die Sicherheitsvorgaben des Modells umgehen soll
Meist die nutzende Person
Inhalte erzeugen lassen, die das Modell sonst ablehnt
Direkte Prompt Injection
Im Eingabefeld der Anwendung
Indirekte Prompt Injection
In Dokumenten, Webseiten, E-Mails oder Werkzeugergebnissen, die das Modell verarbeitet
KI-Jailbreak beziehungsweise LLM-Jailbreak
Meist in einer Eingabe, die Sicherheitsvorgaben des Modells umgehen soll
Laut OWASP ist ein Jailbreak eine Sonderform der Prompt Injection: Ziel ist, dass das Modell gegen seine Sicherheitsvorgaben verstößt.
Für Behörden und Unternehmen, die KI-Modelle mit Dokument-Upload nutzen, ist die indirekte Variante besonders relevant. Das BSI beschreibt in seinem im September 2026 veröffentlichten „Basisschutz gegen Indirect Prompt Injections in dokumentbasierten LLM-Chats“, wie Angreifende Anweisungen in hochgeladene Dokumente einbetten, etwa mithilfe unsichtbarer Unicode-Zeichen oder weißer Schrift auf weißem Hintergrund. Betroffen ist nicht nur der sichtbare Text, sondern auch Metadaten, Annotationen und Kommentare. Die Datei wirkt beim Lesen harmlos, während das Modell die verborgenen Inhalte möglicherweise verarbeitet.
Typische Folgen erfolgreicher Angriffe sind laut BSI Datenabflüsse, die Offenlegung des System-Prompts oder fehlerhaft erledigte Aufgaben.
Als Basisschutz empfiehlt das BSI fünf Maßnahmen, die im Zusammenspiel wirken: die Bereinigung eingelesener Inhalte, die Trennung vertrauenswürdiger und nicht vertrauenswürdiger Inhalte im Prompt, einen gehärteten System-Prompt, die Auswahl eines robusten Modells mit vorgeschaltetem Denkschritt (Reasoning) und die Filterung der Modellausgaben. Für KI-Agenten empfiehlt das BSI zusätzlich, sicherheitskritische Aktionen von Menschen bestätigen zu lassen und Ereignisse kontinuierlich zu protokollieren.
Prompt Injection: Beispiele aus der Praxis
Die folgenden Beispiele zeigen typische Angriffsmuster, ohne konkrete Angriffstexte wiederzugeben.
Direkter Angriff auf einen Kundenchat
Ein Kundenchat soll Auskünfte zu Bestellungen geben. Eine Person fordert das Modell auf, seine bisherigen Vorgaben zu ignorieren und stattdessen eine interne Notiz auszugeben. Diese direkte Prompt Injection soll die Anwendung von ihrer vorgesehenen Aufgabe abbringen.
Verborgene Anweisung in einer Bewerbung
Ein Assistent fasst eingehende Bewerbungen zusammen. Eine der Dateien enthält eine verborgene Anweisung, die Bewerbung besonders positiv darzustellen. Der indirekte Angriff kann die Zusammenfassung beeinflussen, ohne dass dem Team die Anweisung auffällt.
Datenversand durch einen Werkzeugaufruf
Darf ein KI-Assistent Werkzeuge nutzen, kann eine eingeschleuste Anweisung auch eine Handlung auslösen, etwa den Versand von Daten an ein externes Ziel. Die Auswirkungen beschränken sich dann nicht auf eine verfälschte Antwort.
Schutz vor Prompt Injection in mehreren Schichten
Eine einzelne Maßnahme bietet keinen vollständigen Schutz. Unternehmen müssen sowohl eingeschleuste Anweisungen erkennen als auch die Handlungsmöglichkeiten des Modells begrenzen.
Die folgende Tabelle zeigt Schutzschichten und die entsprechenden Funktionen in Myra AI Workspace.
Eingaben prüfen
Angriffsversuche in Eingaben und externen Inhalten erkennen, bevor sie das Modell erreichen
Trainierter Klassifikator für Prompt Injection und Jailbreaks, gehostet in der zertifizierten Myra-Infrastruktur in der EU. Er prüft Nutzereingaben sowie Ergebnisse von Werkzeugen, Websuche und Wissensdatenbank. Ergänzend erkennt ein Filter bekannte Angriffsphrasen, auch in Werkzeugergebnissen.
Externe Inhalte kennzeichnen
Inhalte aus Dokumenten, Webseiten und Werkzeugen als Daten statt als Anweisung markieren
Standardmäßig aktive Kennzeichnung nicht vertrauenswürdiger Inhalte
Inhalte filtern
Schädliche Inhalte in Anfragen und Antworten erkennen
Klassifikator für schädliche Inhalte wie Gewaltdarstellungen, gehostet in der zertifizierten Myra-Infrastruktur in der EU. Er ergänzt die Angriffserkennung, ersetzt sie aber nicht.
Rechte begrenzen
Zugriffe und Werkzeuge auf das für die Aufgabe erforderliche Maß beschränken
Zugriffsstufe pro Projekt; bei „Nur lokal“ sind Cloud-Modelle, Websuche und externe Tools gesperrt
Ausgehende Aufrufe kontrollieren
Vom Modell ausgelöste Aufrufe prüfen
Prüfung vom Modell ausgelöster Abrufe und Suchanfragen; blockiert strukturierte Daten wie E-Mail-Adressen oder Zugangsschlüssel
Menschen einbinden
Folgenreiche Schritte vor der Ausführung freigeben lassen
Workflows mit menschlichem Freigabeschritt; Freigabe einzelner Werkzeugaufrufe bei unbeaufsichtigten Agentenläufen
Daten reduzieren
Sensible Inhalte im Prompt begrenzen
Maskierung personenbezogener Daten vor dem Versand an externe Modelle
Ereignisse nachvollziehen
Änderungen und Sicherheitsereignisse protokollieren
Manipulationserkennbares Audit-Log für Admin-Änderungen und Sicherheitsereignisse
Eingaben prüfen
Angriffsversuche in Eingaben und externen Inhalten erkennen, bevor sie das Modell erreichen
Externe Inhalte kennzeichnen
Inhalte aus Dokumenten, Webseiten und Werkzeugen als Daten statt als Anweisung markieren
Inhalte filtern
Schädliche Inhalte in Anfragen und Antworten erkennen
Rechte begrenzen
Zugriffe und Werkzeuge auf das für die Aufgabe erforderliche Maß beschränken
Ausgehende Aufrufe kontrollieren
Vom Modell ausgelöste Aufrufe prüfen
Menschen einbinden
Folgenreiche Schritte vor der Ausführung freigeben lassen
Daten reduzieren
Sensible Inhalte im Prompt begrenzen
Ereignisse nachvollziehen
Änderungen und Sicherheitsereignisse protokollieren
Begrenzte Rechte reduzieren die Handlungsmöglichkeiten nach einem erfolgreichen Angriff. Ein Modell, das keine Werkzeuge aufrufen oder Daten versenden darf, kann diese Aktionen auch nicht aufgrund einer eingeschleusten Anweisung ausführen.
OWASP betont diesen Zusammenhang in der Ausgabe 2026: Schwere Folgen entstehen vor allem dann, wenn ein Modell nach einer erfolgreichen Injection weitreichende Rechte nutzen kann. Zu weitreichende Befugnisse führt die Liste als eigenes Risiko „Excessive Agency“ auf Platz 3.


Myra AI Workspace bietet Ihrer Organisationen einen geschützten Zugang zu KI.


FAQ zu Prompt Injection und KI-Jailbreaks
Prompt Injection bezeichnet einen Angriff, bei dem eingeschleuste Anweisungen das Verhalten eines Sprachmodells beeinflussen sollen. Sie können direkt in einer Nutzereingabe oder in externen Inhalten stehen. Mögliche Folgen sind verfälschte Antworten, unbeabsichtigte Aktionen und Datenabflüsse.
Quellen
Hier finden Sie die für diesen Artikel herangezogenen Quellen mitsamt Abrufdatum.
- 2026
OWASP GenAI Security Project: OWASP Top 10 for LLM Applications 2026, veröffentlicht am 03.08.2026
- 2026
Basisschutz gegen Indirect Prompt Injections in dokumentbasierten LLM-Chats, Version 1.0 vom 14.09.2026
- 2026
Indirect Prompt Injections – Intrinsische Schwachstelle in anwendungsintegrierten KI-Sprachmodellen, Version 1.0 vom 15.07.2023
Über den Autor


Stefan Bordel
Senior Editor
Über den Autor
Stefan Bordel ist seit 2020 als Editor und Technischer Redakteur bei Myra Security tätig. Er verantwortet die strategische Entwicklung und redaktionelle Betreuung sämtlicher Content-Formate – von Website-Inhalten und Fachpublikationen über Whitepaper bis hin zu Social-Media-Kommunikation und technischer Dokumentation. In dieser Position verbindet er fundierte Expertise aus dem IT-Journalismus mit tiefgreifendem technischem Verständnis im Bereich Cybersecurity. Als langjähriger Linux-Enthusiast beobachtet er die Entwicklungen der IT-Branche sowohl privat als auch beruflich aus nächster Nähe.