Neu: AI Workspace – Sichere KI für Organisationen mit sensiblen Daten. Jetzt mehr erfahren.


Das Wichtigste in Kürze
Definition: AI Guardrails (auch LLM Guardrails oder KI-Guardrails) sind technische Prüfregeln für Prompts, Kontextdaten und Modellantworten.
Funktion: KI-Guardrails markieren, maskieren, blockieren oder protokollieren Inhalte abhängig von Richtlinien.
Typen: Wichtige Guardrails sind Input- und Output-Filter, PII-Schutz, Content-Moderation, Prompt-Injection-Erkennung und Egress-Kontrolle.
Betrieb: Am wirksamsten sind Guardrails als zentrale Pipeline in einem AI Gateway.
Grenzen: Guardrails reduzieren Risiken, ersetzen aber keine Zugriffskontrollen, Tests, Monitoring und menschliche Freigaben.


Wie funktionieren AI Guardrails?
AI Guardrails funktionieren als Prüfschicht zwischen Nutzenden, Anwendungen, Tools und dem KI-Modell. Sie analysieren Eingaben vor dem Modellaufruf, prüfen ausgehende Tool- oder Webaufrufe und kontrollieren Modellantworten vor der Ausgabe. Die Regeln laufen meist als Pipeline: schnelle Musterprüfungen zuerst, aufwendigere Klassifikatoren danach.
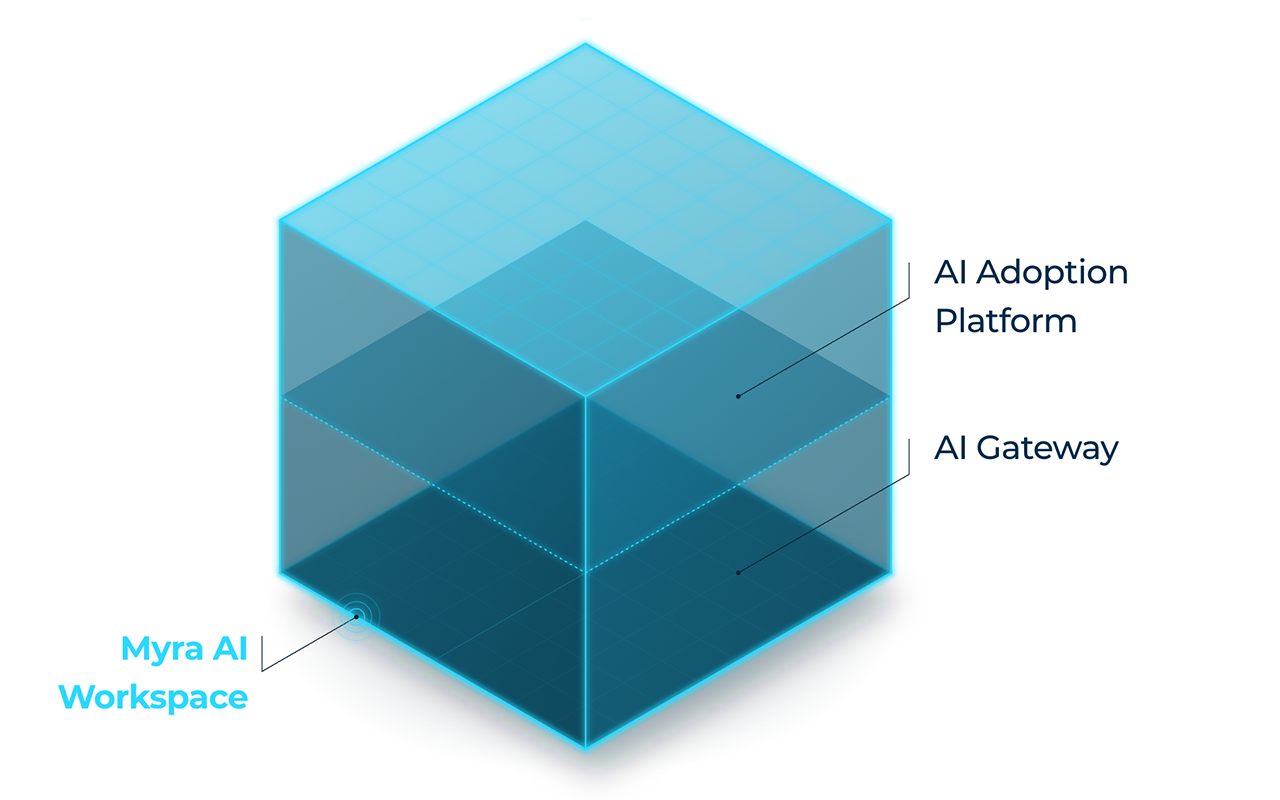
Guardrails sitzen im Datenpfad zwischen Nutzenden oder Anwendungen und dem KI-Modell. Am wirksamsten arbeiten sie in einer zentralen Kontrollschicht wie einem AI Gateway, wo jede Anfrage denselben Regeln unterliegt.
Eine Prüfung läuft typischerweise in diesen Schritten ab:
Anfrage prüfen: Vor dem Modellaufruf analysieren die Guardrails den Prompt, je nach Konfiguration auch Systemanweisungen und angehängte Inhalte.
Ergebnis anwenden: Jede Regel liefert ein Ergebnis. Je nachdem, wie dieses ausfällt, wird die Verarbeitung blockiert, Inhalte bereinigt, Prüftreffer protokolliert oder die Anfrage erlaubt.
Modell aufrufen: Nur eine zugelassene, gegebenenfalls bereinigte Anfrage erreicht das Modell.
Ausgehende Aufrufe prüfen: Startet das Modell selbst einen Aufruf nach außen, etwa einen Webabruf, prüft eine Egress-Kontrolle das Ziel.
Antwort prüfen: Output-Guardrails kontrollieren die Modellantwort, bevor sie an Nutzende ausgegeben wird. Maskierte Werte können hier wieder eingesetzt werden.
Protokollieren: Welche Regel wann angeschlagen hat, landet im Log und dient als Nachweis für Audits.
Die Reihenfolge wirkt sich auf Kosten und Latenz aus. Bewährt hat sich, schnelle regelbasierte Prüfungen vor aufwendigen Klassifikatoren auszuführen. Was bereits ein einfacher Musterabgleich blockiert, muss kein NLP-Modell mehr bewerten.
Welche Typen von AI Guardrails gibt es?
AI Guardrails lassen sich nach ihrer Aufgabe gruppieren. In der Praxis überschneiden sich die Typen: Ein Keyword-Filter kann zugleich Input-Filter und Policy-Regel sein. Wichtig ist hier die Frage, an welcher Stelle der Pipeline ein Risiko entsteht, wenn die Regel fehlt.
Input-Filter
Prompts, Systemanweisungen, angehängte Inhalte
Keywords, reguläre Ausdrücke, Klassifikatoren
Blockieren, maskieren, markieren
Output-Filter
Modellantworten
Musterabgleich, Schemaprüfung, Klassifikatoren
Blockieren, markieren, Werte wieder einsetzen
Content-Moderation
Schädliche oder unzulässige Inhalte
Sicherheitsklassifikatoren mit Kategorien
Blockieren, markieren
PII-Schutz
Personenbezogene und vertrauliche Daten
Muster, Named Entity Recognition (NER), Tokenisierung
Maskieren, tokenisieren, blockieren
Themen- und Policy-Regeln
Verbotene Themen, Begriffe, Schriftsysteme, Formate
Keyword-Listen, Schriftsystem- und Code-Erkennung
Blockieren, markieren
Prompt-Injection-Erkennung
Manipulationsversuche in Prompts und Tool-Ergebnissen
Phrasenlisten, trainierte Klassifikatoren
Blockieren, markieren
Egress-Kontrolle
Ausgehende Aufrufe, die das Modell selbst auslöst
Musterabgleich, auch auf kodierte Varianten
Blockieren, markieren
Input-Filter
Prompts, Systemanweisungen, angehängte Inhalte
Output-Filter
Modellantworten
Content-Moderation
Schädliche oder unzulässige Inhalte
PII-Schutz
Personenbezogene und vertrauliche Daten
Themen- und Policy-Regeln
Verbotene Themen, Begriffe, Schriftsysteme, Formate
Prompt-Injection-Erkennung
Manipulationsversuche in Prompts und Tool-Ergebnissen
Egress-Kontrolle
Ausgehende Aufrufe, die das Modell selbst auslöst
Kurz gesagt: Die wichtigsten Typen von AI Guardrails sind Input- und Output-Filter, Content-Moderation, PII-Schutz, Themen- und Policy-Regeln, Prompt-Injection-Erkennung und Egress-Kontrolle. Sie unterscheiden sich darin, was sie prüfen, wie sie es erkennen und welche Aktion sie auslösen.
Input- und Output-Filter
Input-Filter prüfen alles, was an ein Modell geht. Output-Filter prüfen alles, was zurückkommt. Beide brauchen eigene Regeln: Eingaben enthalten oft sensible Daten oder Manipulationsversuche, Antworten können unerwünschte Inhalte, falsche Formate oder unerwartet Quellcode enthalten.
Typische Output-Prüfungen sind die Validierung gegen ein JSON-Schema bei maschinell weiterverarbeiteten Antworten, die Erkennung von unverständlichem oder fehlerhaftem Text und die Wiederherstellung zuvor maskierter Werte.
Content-Moderation
Content-Moderation erkennt schädliche, illegale oder richtlinienwidrige Inhalte, etwa Gewalt, Hassrede oder Anleitungen zu Waffen. Dafür kommen Sicherheitsklassifikatoren zum Einsatz, die Text einer Reihe von Kategorien zuordnen. Ein verbreitetes Modell ist Llama Guard 3 von Meta, das 14 Gefahrenkategorien unterscheidet.
Content-Moderation erkennt die Absicht auch dann, wenn sie umschrieben ist. Dafür ist sie anfälliger für Fehlalarme, besonders in fachlichen Kontexten wie Recht, Medizin oder IT-Sicherheit. Administrierende sollten deshalb gezielt festlegen, welche Kategorien aktiv sind und ob ein Treffer blockiert oder nur markiert wird.
PII-Schutz
PII-Guardrails schützen personenbezogene Daten (Personally Identifiable Information) wie Namen, E-Mail-Adressen, Telefonnummern, IBANs oder Ausweisnummern. Drei Verfahren sind üblich:
Musterbasierte Erkennung für strukturierte Daten mit festem Format, etwa Kreditkartennummern mit Prüfsumme oder IBANs. Sie ist schnell und präzise, eignet sich aber nicht für Freitext.
NLP-basierte Erkennung per Named Entity Recognition für unstrukturierte Angaben wie Namen oder Orte im Fließtext.
Reversible Tokenisierung: Erkannte Werte werden vor dem Modellaufruf durch Platzhalter ersetzt und in der Antwort wieder eingesetzt. Das Modell arbeitet mit pseudonymisierten Daten, die Nutzenden sehen die Originalwerte.
Themen- und Policy-Regeln
Themen- und Policy-Regeln übersetzen interne Richtlinien in technische Prüfungen. Beispiele sind gesperrte Projektnamen oder Produktcodes, verbotene Themen für einen Kundenservice-Bot, die Beschränkung auf bestimmte Schriftsysteme oder ein Verbot, Quellcode über einen KI-Endpunkt auszutauschen.
Diese Regeln arbeiten meist deterministisch: Ein Begriff steht auf der Liste oder nicht. Das macht sie nachvollziehbar, aber auch leicht zu umgehen, sobald jemand anders formuliert.
Prompt-Injection-Erkennung
Prompt Injection bezeichnet Eingaben, die ein Modell dazu bringen sollen, seine (Sicherheits-)Vorgaben zu ignorieren. Bei direkter Prompt Injection steht die Anweisung im Prompt selbst („Ignoriere alle bisherigen Anweisungen“). Bei indirekter Prompt Injection ist sie in Inhalten versteckt, die das Modell verarbeitet: in einer abgerufenen Webseite, einem hochgeladenen Dokument oder einem Tool-Ergebnis.
Phrasenlisten fangen bekannte Angriffsmuster ohne messbare Latenz ab. Trainierte Klassifikatoren erkennen zusätzlich umformulierte, mehrsprachige oder verschleierte Varianten. Weil indirekte Angriffe über Tool-Ergebnisse laufen, sollten Guardrails auch diese Inhalte prüfen, bevor sie in das Modell zurückfließen.
Egress-Kontrolle
Egress-Kontrolle prüft Aufrufe, die ein Modell selbst nach außen startet, etwa einen Webabruf oder eine Suchanfrage. Sie greift, wenn eine indirekte Prompt Injection bereits gewirkt hat und das Modell Daten über eine präparierte URL abfließen lassen soll.
Erkennt die Guardrail im Ziel strukturierte Kennungen oder vertrauliche Informationen wie E-Mail-Adressen, IBANs oder API-Keys, blockiert sie den Aufruf – aber nur, wenn der Wert nicht aus den eigenen Eingaben der Nutzenden stammt. Normale Webabrufe funktionieren deshalb weiterhin. Die Egress-Kontrolle ist somit die letzte Absicherung gegen den Abfluss strukturierter Daten: Sie kann auch dann greifen, wenn alle vorgelagerten Prüfungen einen Angriff übersehen haben.
AI Guardrails konfigurieren: Beispiele aus der Praxis
Wie Guardrails konfiguriert werden, hängt von der eingesetzten KI-Lösung ab. Die folgenden Beispiele zeigen eine typische Konfiguration im AI Gateway von Myra AI Workspace. Dort werden Guardrails pro Gateway als Pipeline definiert, entweder im visuellen Guardrail Builder auf der Detailseite des Gateways oder als JSON über die Konfigurations-API. AI Guardrails umfassen eine geordnete Liste von Regeln. Jede Regel legt fest, welcher Detektor prüft, ob Anfrage, Antwort oder beides untersucht wird und welche Aktion bei einem Treffer folgt: blockieren, maskieren oder markieren.
Drei Parameter kehren in jeder Regel wieder:
type: der Detektor (z. B. keyword, regex, jailbreak oder pii_protector)
target: die Prüfrichtung (z. B. request, response oder both)
action: die Reaktion bei einem Treffer (z. B. block, scrub oder flag). Nicht jeder Detektor unterstützt jede Aktion.
Myra AI Workspace führt Guardrails in zwei Stufen aus. Stufe 1 läuft direkt im Gateway im Sub-Millisekunden-Bereich und umfasst Regex, Keyword, Jailbreak-Erkennung, JSON-Schema, Code-Erkennung, Gibberish-Erkennung, Beschränkung auf Schriftsysteme und eine eigene PII-Blacklist. Stufe 2 nutzt NLP-Modelle, die als Sidecars innerhalb der Myra-Infrastruktur laufen und im Millisekunden-Bereich antworten. Dazu zählen NLP-PII-Erkennung, PII Protector, Prompt Guard und Prompt Injection. Stufe 1 läuft immer vor Stufe 2.
Andere Plattformen verwenden andere Bezeichnungen und Detektoren, das Prinzip bleibt jedoch ähnlich. Auch die konkrete Syntax unterscheidet sich je nach Plattform. Entscheidend ist, dass jede Regel Detektor, Prüfrichtung und Reaktion definiert.
Beispiel 1: Basis-Pipeline für ein Gateway mit Personendaten
Diese Pipeline blockiert bekannte Jailbreak-Phrasen, strukturierte Zahlungs- sowie Zugangsdaten und tokenisiert anschließend personenbezogene Daten im Fließtext:
[
  {
    "type": "jailbreak",
    "name": "block-jailbreaks",
    "action": "block",
    "target": "request"
  },
  {
    "type": "regex",
    "name": "block-payment-and-credentials",
    "action": "block",
    "target": "request",
    "patterns": ["pci_pan", "credentials"]
  },
  {
    "type": "pii_protector",
    "name": "tokenize-pii",
    "target": "both",
    "entities": ["PERSON", "EMAIL_ADDRESS", "PHONE_NUMBER", "LOCATION"],
    "fail_open": false
  }
]
Die Pattern-Sets pci_pan (Karten- und Kontodaten) und credentials (API-Keys, JSON Web Tokens) haben eine niedrige Fehlalarmrate und eignen sich deshalb zum Blockieren. Der PII Protector hat keine action: Er tokenisiert immer. Der Wert fail_open: false sorgt dafür, dass Anfragen blockiert statt ungeschützt weitergeleitet werden, falls die Erkennung nicht erreichbar ist. Laufen Modell und alle Fallback-Modelle auf Myra-Infrastruktur, entfällt die Maskierung, weil die Daten die Myra-Infrastruktur nicht verlassen. Blockierende Regeln und die Maskierung ausgehender Tool-Aufrufe gelten weiterhin.
Beispiel 2: Themen- und Policy-Regel mit Keyword-Liste
Ein vertraulicher Projektname soll nicht in Prompts auftauchen:
{
  "type": "keyword",
  "name": "secret-project",
  "action": "block",
  "target": "request",
  "keywords": ["Projekt Falke", "FALKE-2027"],
  "case_sensitive": false,
  "whole_word": true
}
Der Parameter whole_word: true sorgt dafür, dass nur das vollständige Keyword einen Treffer auslöst. Bei einer Blockierung nennt die Meldung den auslösenden Detektor, nicht aber den geschützten Begriff selbst. So legt auch die Fehlermeldung keine vertraulichen Begriffe offen.
Welche Grenzen haben AI Guardrails?
AI Guardrails können das Risiko eines Datenabflusses nicht vollständig eliminieren, aber deutlich reduzieren. Dazu sollten sie in mehreren Schichten angeordnet, mit eigenen Daten getestet und regelmäßig nachjustiert werden. Denn die Filterung arbeitet nie hundertprozentig fehlerfrei. Sie blockiert eventuell legitime Anfragen (False Positives) oder übersieht manchmal kritische Inhalte (False Negatives). Hinzu kommen eine bewusste Umgehung durch Umformulieren, Kodieren oder Sprachwechsel sowie Abdeckungslücken.
False Positives
Ein False Positive bedeutet hier, dass die Guardrail eine legitime Anfrage blockiert. Das frustriert Nutzende und treibt sie im schlimmsten Fall zurück zu Schatten-KI, also zu einer nicht freigegebenen Nutzung externer KI-Dienste.
Bewährte Gegenmaßnahmen:
Maskieren statt blockieren bei fehleranfälligen Mustern. Ein maskierter Wert stört die Arbeit weniger als eine abgelehnte Anfrage.
Kontext mitgeben: Ein Einsatzkontext senkt bei Klassifikatoren die Fehlalarmquote.
NLP statt Muster für Freitext, weil der Kontext Fehlinterpretationen reduziert.
Umgehung
Regelbasierte Guardrails erkennen nur, was wörtlich auf der Prüfliste steht. Umformulierungen, Übersetzungen, Leerzeichen- und Unicode-Tricks oder unsichtbare Zeichen im Wort reichen oft aus, um einen Keyword- oder Phrasenfilter zu umgehen. Klassifikatoren erkennen deutlich mehr Varianten, sind aber ebenfalls nicht lückenlos.
Hinzu kommen Abdeckungsgrenzen. Klassifikatoren prüfen aus Latenzgründen oft nur einen Ausschnitt. Solche Grenzen sollten Security-Teams kennen und bei der Risikobewertung berücksichtigen.
Verfügbarkeit und Latenz
NLP-basierte Guardrails rufen ein Modell auf. Ist es nicht erreichbar, muss die Konfiguration entscheiden, ob die Anfrage durchgelassen oder blockiert wird. Für Datenschutz und Prompt-Injection-Schutz ist Letzteres die sichere Wahl, für reine Qualitätsprüfungen kann Ersteres vertretbar sein. Jede zusätzliche Stufe kostet zudem Millisekunden. Deshalb gehören schnelle Regeln an den Anfang der Pipeline.
False Negatives
Das Gegenstück zum Fehlalarm ist der übersehene Treffer: Eine Guardrail lässt einen kritischen Inhalt passieren. Wie hoch beide Quoten ausfallen, zeigen erst Tests mit echten Beispieltexten aus der eigenen Organisation. Auch Open-Source-Werkzeuge benennen diese Grenze offen. Das Projekt Presidio, auf dem viele PII-Detektoren aufbauen, weist darauf hin, dass es keine Garantie gebe, dass Presidio sämtliche vertraulichen Informationen erkenne.
Eine weitere Lücke betrifft die Maskierung selbst: Gibt ein Modell einen maskierten Wert in eigenen Worten wieder, statt den Platzhalter zu wiederholen, wird dieser Wert nicht zurückübersetzt. Ähnliches gilt für Sprachen: Die Erkennung ist für bestimmte Sprachen kalibriert und arbeitet bei anderen weniger zuverlässig.
Defense in Depth statt Einzelschutz
Guardrails ersetzen weder Rechtemanagement noch Prozesse. Sie sind eine Sicherheitsschicht unter mehreren. Dazu gehören Zugriffsstufen, restriktive Berechtigungen für Tools und Konnektoren nach dem Prinzip der minimalen Rechte, Freigabeschritte durch Menschen, eine klare Trennung von Anweisungen und Daten im System Prompt sowie Monitoring und Audit.
Myra AI Workspace kennzeichnet Inhalte aus Dateien, Webseiten und Tool-Ergebnissen zum Beispiel standardmäßig als nicht vertrauenswürdige Daten, damit das Modell darin eingebettete Anweisungen nicht befolgt.
Wie wähle ich die richtigen AI Guardrails aus?
Die passende Kombination ergibt sich aus Datenklassen, Anwendungsfall und regulatorischen Anforderungen. Eine pragmatische Zuordnung am Beispiel von Myra AI Workspace:
Personenbezogene Daten dürfen nicht zum externen Modell
PII-Tokenisierung oder NLP-PII-Erkennung mit Maskierung, als Pflicht für das Projekt
Besonders sensible Daten und Geschäftsgeheimnisse
Projekt auf „Nur lokal“, Verarbeitung ausschließlich durch von Myra auf eigener EU-Infrastruktur gehosteten Modellen
Zahlungsdaten und Zugangsdaten sperren
Regex mit formatgenauen Mustern, Aktion „Blockieren“
Vertrauliche Begriffe schützen
Keyword-Liste (blockieren) oder PII-Blacklist (maskieren und wiederherstellen)
Jailbreaks und Prompt Injection abwehren
Jailbreak-Detektor mit vordefinierten Phrasen, optional Keyword-Detektor mit eigener Phrasenliste, dazu der Klassifikator Llama Prompt Guard 2
Datenabfluss über Webabrufe verhindern
Egress-Kontrolle
Schädliche Inhalte filtern
Prompt Guard (Llama Guard 3) mit einzeln aktivierbaren Kategorien (S1 bis S14)
Strukturierte Ausgaben erzwingen
JSON-Schema-Prüfung auf der Antwort
Quellcode-Austausch unterbinden
Code-Erkennung
Personenbezogene Daten dürfen nicht zum externen Modell
PII-Tokenisierung oder NLP-PII-Erkennung mit Maskierung, als Pflicht für das Projekt
Besonders sensible Daten und Geschäftsgeheimnisse
Projekt auf „Nur lokal“, Verarbeitung ausschließlich durch von Myra auf eigener EU-Infrastruktur gehosteten Modellen
Zahlungsdaten und Zugangsdaten sperren
Regex mit formatgenauen Mustern, Aktion „Blockieren“
Vertrauliche Begriffe schützen
Keyword-Liste (blockieren) oder PII-Blacklist (maskieren und wiederherstellen)
Jailbreaks und Prompt Injection abwehren
Jailbreak-Detektor mit vordefinierten Phrasen, optional Keyword-Detektor mit eigener Phrasenliste, dazu der Klassifikator Llama Prompt Guard 2
Datenabfluss über Webabrufe verhindern
Egress-Kontrolle
Schädliche Inhalte filtern
Prompt Guard (Llama Guard 3) mit einzeln aktivierbaren Kategorien (S1 bis S14)
Strukturierte Ausgaben erzwingen
JSON-Schema-Prüfung auf der Antwort
Quellcode-Austausch unterbinden
Code-Erkennung
Starten Sie mit einer kleinen, gut strukturierten Pipeline, testen Sie sie mit echten Beispieltexten, werten Sie die Logs über einige Wochen aus und erweitern Sie die Regeln schrittweise. Guardrails sind technisch umgesetzte Richtlinien, und Richtlinien brauchen Verantwortliche. Binden Sie daher Verantwortliche für Datenschutz und Informationssicherheit sowie Fachabteilungen frühzeitig ein.


Häufig gestellte Fragen zu AI Guardrails (FAQ)
AI Guardrails sind automatisierte Prüfregeln, die Anfragen an KI-Modelle und deren Antworten kontrollieren. Sie erkennen etwa personenbezogene Daten, verbotene Themen oder Manipulationsversuche und markieren, maskieren oder blockieren die betroffenen Inhalte. So setzen Organisationen Datenschutz- und Sicherheitsrichtlinien unabhängig vom genutzten Modell technisch durch.
Über den Autor


Björn Greif
Senior Editor
Über den Autor
Björn Greif startete seine Redakteurskarriere 2006 beim IT-Nachrichtenportal ZDNet. 10 Jahre und exakt 12.693 Artikel später engagierte er sich beim deutschen Start-up Cliqz für mehr Privatsphäre und Datenschutz im Web. Vom Datenschutz zur IT-Sicherheit war es dann nur noch ein kleiner Schritt: Seit 2020 schreibt Björn bei Myra über die neusten Trends und Entwicklungen in der Welt der Cybersecurity.